两万亿俱乐部的新成员
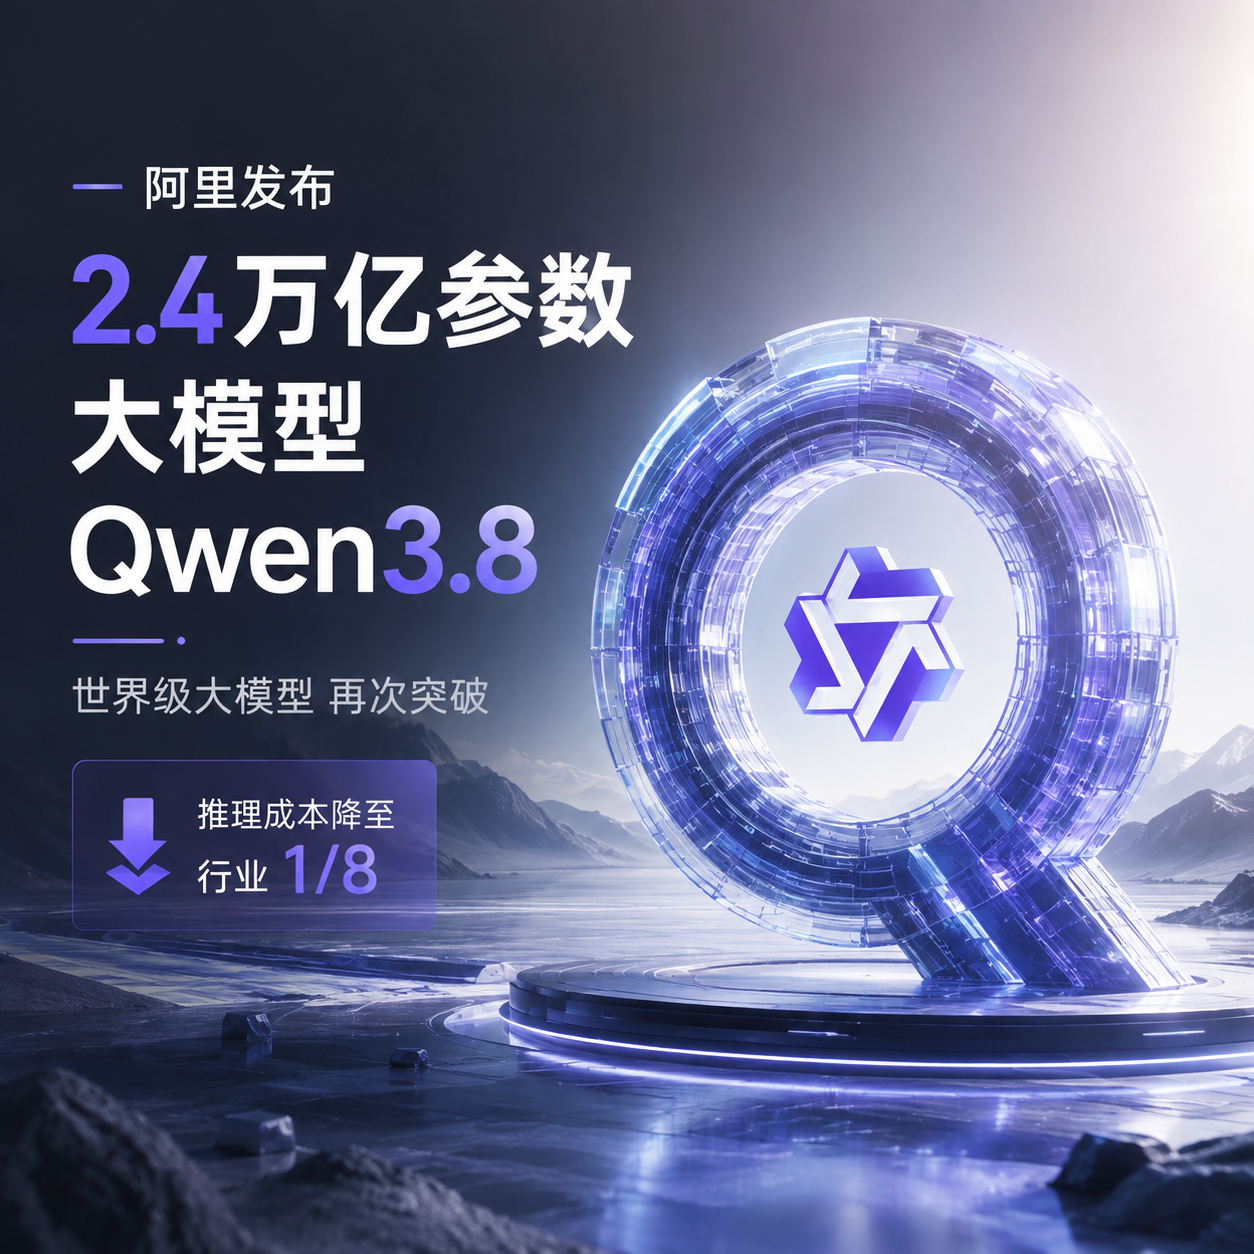
8月3日,阿里巴巴正式发布了新一代基座大模型Qwen3.8。总参数量达到了2.4万亿——继Kimi K3之后,国产大模型“两万亿俱乐部”再添一员。
这个数字什么概念?两年前,前沿模型能写好函数、补全代码就已经很了不起了。而现在,Qwen3.8可以从一个空文件夹出发,自主完成一个需要十几天才能做完的真实项目,全程不用人插手。据说它独立编程跑了大概16天,硬生生做出了一个真实可用的自进化智能体框架,项目已经在GitHub上开源了。
性能到底有多能打?
光说参数没意思,咱们看看实际表现。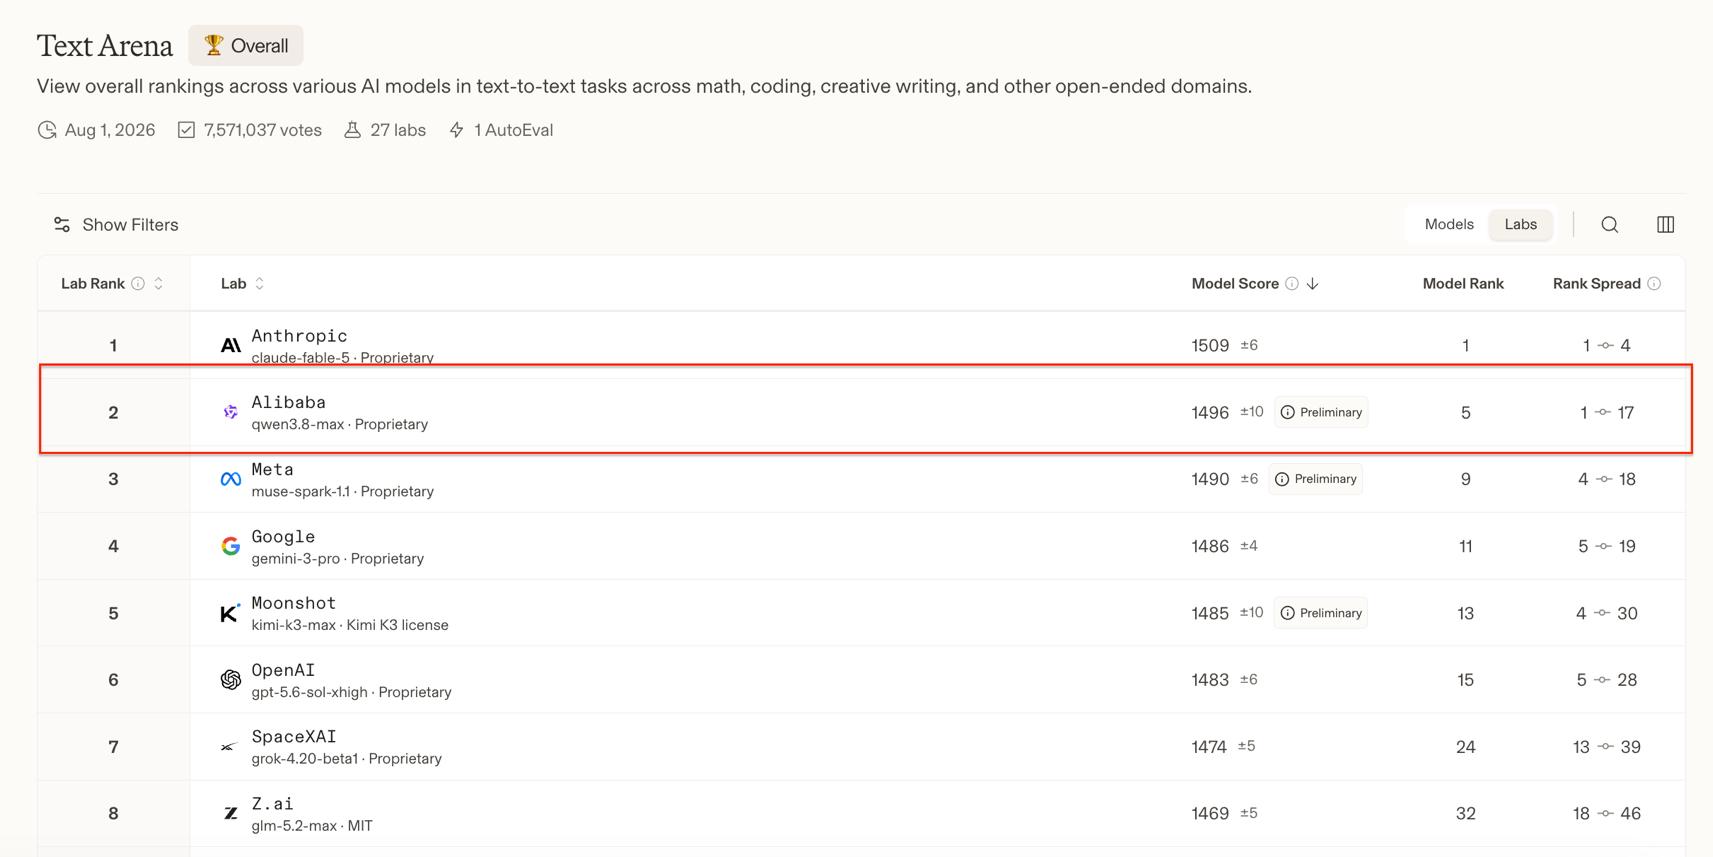
在权威第三方榜单Arena中,阿里Qwen模型排名全球第二,仅次于Anthropic的Claude系列。在编程能力的CodeArena榜单上,Qwen3.8排在全球第四。指令遵循能力拿了82.8分,科学推理GPQA Diamond考了92.6分。视觉推理方面,在无工具条件下拿了82分,超出部分主流模型将近两倍。在评估智能体电脑操作能力的OSWorld-Verified评测中,直接以86.1分拿了第一。
简单说就是——能写代码、能看图表、能操作电脑、能推理分析,各方面都很均衡,属于那种“你让它干啥它都能干得不错”的类型。
最让人意外的是成本
大模型好用的很多,但用得起的没几个。这次Qwen3.8最让人惊喜的,其实是价格。
目前Qwen3.8-Max每百万输出Token的推理成本大约是6美元。而行业主流标杆模型的价格是多少?50美元。差了八倍多。国内价格也很亲民,每百万Token输入12元、输出36元。
怎么做到的?Qwen3.8用了稀疏MoE架构,总参数虽然高达2.4万亿,但每次推理实际激活的只有约950亿参数。打个比方,就像一个拥有两万员工的超级公司,每次接任务只调动最对口的九百多人干活——人多但不浪费。再加上阿里自研的“真武M890”超节点,从芯片到云平台做了全链路优化,在Agentic推理场景中最多能实现1.5倍的性能提升。
开源,这次是认真的
还有一个消息值得关注:Qwen3.8-Max的模型权重预计下周开源。这是阿里第一次把Max级别的旗舰模型权重开放出来。同时还会开源一个Qwen3.8-27B的版本。
以前这种级别的模型基本都是闭源的,想用只能调API。现在直接开放源代码,对开发者、研究者和中小型企业来说,门槛一下子低了很多。
同一天,阿里还推出了企业级Agent产品“千问办公”,把Qwen3.8的能力直接打包成一个可以落地使用的工具。
一点感想
从2023年大模型爆发到现在,也就三年时间。参数从千亿到万亿再到两万亿,能力从“能聊天”到“能写代码”再到“能独立完成一个项目”。技术迭代的速度确实让人眼花缭乱。
但说到底,模型再大、参数再多,最终还是要落到“用得起、用得好”上。Qwen3.8这次把推理成本打到行业的八分之一,再加上即将开源——这两件事放在一起,可能比单纯堆参数更有意义。毕竟,AI真正改变世界的那一刻,不是它变得多聪明,而是每个人都用得上。
阿里发布2.4万亿参数大模型Qwen3.8,推理成本降至行业1/8
0
0
此篇文章发布距今已超过93天,您需要注意文章的内容或图片是否可用!
AI Insight
文章解析
准备就绪
文章告知
访问者可将本网站提供的内容或服务用于个人学习、研究或欣赏,以及其他非商业性或非盈利性用途,但同时应遵守著作权法及其他相关法律的规定,不得侵犯本网站及相关权利人的合法权利。除此以外,将本网站任何内容或服务用于其他用途时,须征得本网站及相关权利人的书面许可,并支付报酬。